
Données sensibles (DSPM)
Les identifiants cherchés dans les buckets, les bases PostgreSQL, les copies de disques et le code des fonctions, les formats lus, l'échantillonnage, ce que Ctadel conserve et la page « Sécurité des données ».
Le module de données sensibles cherche, dans le contenu de vos ressources de stockage, des identifiants au format connu : numéros de carte, IBAN, numéros de sécurité sociale, identifiants de santé. Il lit les buckets, une copie temporaire de vos bases PostgreSQL, les copies de disques et le code des fonctions serverless, et produit un constat par règle et par emplacement. Il ne conserve jamais la donnée trouvée, seulement un extrait masqué.
Ce qui est cherché
Chaque règle est une expression régulière tirée d'une norme publiée (RFC, ISO, autorité nationale, spécification d'un émetteur de cartes), citée dans la description de la règle. Quand l'identifiant porte une clé de contrôle, un validateur la vérifie (Luhn pour les cartes, modulo 97 pour l'IBAN, et ainsi de suite) : une suite de chiffres qui ressemble à l'identifiant mais ne passe pas la clé n'est pas rapportée. Les identifiants qui ne sont qu'une suite de chiffres (NPI, IMSI, Aadhaar, TFN) ne sont cherchés qu'à côté de leur mot-clé (« NPI: 1234567893 », colonne aadhaar_number) ou dans leur format imprimé.
| Catégorie affichée | Ce qu'elle regroupe |
|---|---|
PCI | Numéros de carte de paiement (Visa, MasterCard, American Express, Discover, JCB, Diners), avec et sans préfixe d'émetteur connu |
Financial | IBAN, BIC, numéros de routage et de guichet (ABA, BSB, IFSC, Sort Code), identifiants de titres (CUSIP, ISIN, LEI, SEDOL), identifiants fiscaux et d'entreprise (EIN, ITIN, UTR, IRD, TFN, ABN, CPF, CNPJ, TVA, SIREN, SIRET, TVA française), adresses Bitcoin, Ethereum et Monero, CVV, dates d'expiration, BIN, pistes magnétiques, cartes masquées |
PII | Numéros de sécurité sociale et d'identité nationale (France NIR, États-Unis SSN, Royaume-Uni NINO, Suisse AHV, Espagne DNI, Portugal NIF et DNI, Irlande PPSN, Canada SIN, Mexique CURP, Inde PAN et Aadhaar, Japon My Number, Bulgarie EGN, Israël, Australie CRN, identifiants du ministère de la Défense américain, A-Number), adresses de courriel, numéros de téléphone, IMSI, VIN |
PHI | Identifiants de santé : NPI, DEA, numéros NHS et NHI, Medicare américain (MBI, HICN) et australien, codes CPT, HCPCS, NDC, LOINC, ATC, ICD-9 et ICD-10 |
DigitalIdentity | IMEI, identifiants publicitaires Apple (IDFA) et Google (GAID), ESN, mots de passe hachés |
Chaque règle porte une sévérité (CRITICAL, HIGH, MEDIUM, LOW), un niveau de confiance et une liste de périmètres : volume, bucket, database. Une règle n'est jouée que sur ses périmètres. La page « Politiques », onglet « DSPM », permet d'activer ou de désactiver chaque règle ; voir Politiques.
Le catalogue ne cherche pas ce qui n'a pas de format syntaxique : les catégories de l'article 9 du RGPD (religion, orientation sexuelle, opinion politique, origine ethnique), les contenus sémantiques (salaire, solde, historique de commandes), les documents de processus (audits, recherche médicale). La règle « Internal or external email » détecte une adresse de courriel ; elle ne distingue pas les adresses internes des externes.
Où Ctadel cherche
| Emplacement | Ce qui est lu |
|---|---|
| Buckets | Les objets des buckets de tous les clouds connectés |
| Bases de données | Une copie temporaire des instances PostgreSQL d'AWS, Google Cloud et Scaleway |
| Disques | Les fichiers d'une copie de disque des machines, décrite dans Hôtes |
| Fonctions serverless | Les fichiers texte du paquet de code des fonctions |
Buckets
À chaque inventaire complet, Ctadel lance une lecture par bucket présent dans le graphe, avec les identifiants du compte qui le porte. Les buckets S3 d'AWS, Scaleway Object Storage, OVHcloud Object Storage (API S3), OUTSCALE OOS, Google Cloud Storage et Azure Blob Storage sont lus. Pour Azure, la lecture porte sur le compte de stockage : tous ses conteneurs sont parcourus ; la lecture passe par le rôle « Storage Blob Data Reader » du service principal, ou par la clé du compte quand le compte a été connecté avec une.
Ctadel liste jusqu'à 100 000 objets par bucket ; au-delà, la liste est tronquée et le résultat est marqué incomplet.
| Type d'objet | Lecture | Taille |
|---|---|---|
| Fichier texte (tout ce qui n'est pas dans la ligne suivante) | Échantillon du début du fichier | 10 Mo au plus |
.pdf, .zip, .tar, .gz, .tgz, .xlsx, .xlsm, .xls, .docx, .doc, .pptx, .odt, .ods | Téléchargement complet puis extraction du texte | 50 Mo au plus par objet ; un objet plus lourd est tronqué à 50 Mo et compté comme non lisible |
Détails de l'extraction :
- Archives : profondeur d'imbrication 3, 100 fichiers par archive, 10 Mo par fichier extrait ; les fichiers plus gros sont ignorés.
- Office et OpenDocument : les documents sont lus comme des archives XML ; une partie qui dépasse 32 Mio une fois décompressée est refusée (protection contre les archives piégées). Les
.docet.xlsantérieurs à 2007 sont lus par extraction des chaînes de caractères qu'ils contiennent. - PDF : le texte est extrait du document (32 Mio au plus une fois décompressé) ; les PDF qui ne sont qu'une image n'ont pas de texte à lire.
- Encodage : les objets en UTF-16 (sorties PowerShell, export Excel « Texte Unicode ») sont décodés avant la recherche, avec ou sans marque d'ordre des octets.
- CSV et TSV : chaque valeur est préfixée du nom de sa colonne (
iban: FR76...), y compris dans une archive, ce qui permet aux règles ancrées sur un mot-clé de reconnaître une colonnenpiounir.
Bases de données
Ctadel ne se connecte jamais à votre base de production. Pour chaque instance PostgreSQL du graphe, Ctadel crée une copie dans votre compte, la lit, puis la supprime. La copie coûte le prix d'une petite instance pendant la durée du scan.
| Cloud | Copie créée | Classe | Suppression |
|---|---|---|---|
| AWS RDS | Instantané ctadel-dspm-snap-<horodatage> puis restauration en ctadel-dspm-clone-<horodatage>, tous deux étiquetés Ctadel ; un groupe de sécurité temporaire n'ouvre le port qu'à la plage de sortie de votre instance Ctadel ; le mot de passe maître est réinitialisé sur la copie seulement | db.t3.micro | Instance, instantané et groupe de sécurité |
| Google Cloud SQL | Clone ctadel-dspm-<horodatage> par l'API d'administration Cloud SQL | Celle de la source | Clone |
| Scaleway Managed Database | Clone ctadel-dspm-clone-<horodatage> | DB-PLAY2-PICO | Clone |
La suppression est faite dans tous les cas, y compris après une erreur ou une interruption pendant la lecture. Une seule copie est en cours à la fois. L'adresse publique de la copie AWS dépend du réglage décrit dans Réglages du scanner.
Seul PostgreSQL est lu. Un moteur MySQL, Oracle, SQL Server, MongoDB ou Redis, et un cluster Aurora, sont écartés avant toute création ; l'ordre est abandonné sans copie. Azure SQL et les bases managées OVHcloud ne sont pas scannées : pour ces services, aucune lecture qui laisse l'instance source intacte n'est disponible à ce jour, et Ctadel préfère ne pas scanner plutôt que de toucher la source.
Sur la copie, un compte ctadel_dspm_scanner est créé avec un mot de passe aléatoire. Ctadel liste les bases auxquelles ce compte peut se connecter (les bases de maintenance rdsadmin, cloudsqladmin, azure_* sont exclues ; postgres est conservée), puis dans chacune :
- Les colonnes de type
text,character varying,character,json,jsonb,xml,citextethstorede tous les schémas hors système sont listées, jusqu'à 5 000 colonnes. Au-delà, le résultat est marqué incomplet. - Pour chaque colonne, 100 lignes tirées au hasard sont lues. Chaque valeur est examinée avec le nom de sa colonne devant elle.
- Un constat est produit par règle et par colonne, avec le nombre de correspondances dans l'échantillon, la taille de l'échantillon et le nombre total de lignes de la table. La page affiche une estimation : correspondances multipliées par le rapport lignes totales sur lignes lues.
Si une base a des tables mais aucune colonne lisible, le compte de scan manque de droits : le résultat est marqué incomplet plutôt que « propre ».
Disques et fonctions
Le scanner qui lit les copies de disques du module Hôtes applique aussi les règles DSPM de périmètre volume. Il parcourt l'arborescence en ignorant les répertoires système (proc, sys, dev, les données du moteur de conteneurs, var/log, usr/lib, caches des gestionnaires de paquets), les binaires et les fichiers de plus de 256 Mo. Les fichiers .pem, .crt, .cer et .key ne sont lus que par les règles de secrets. Les archives, PDF, .xlsx, .docx et .jar sont extraits comme dans les buckets.
Le scanner de fonctions serverless télécharge le paquet de code de chaque fonction et applique les mêmes règles à ses fichiers texte, avec le même étiquetage des CSV et TSV.
Ce que Ctadel conserve
Le contenu lu reste dans votre compte : seuls des constats sont conservés par Ctadel. Un constat de données comporte :
| Champ | Contenu |
|---|---|
| Ressource | L'identifiant du bucket, de la base, du disque ou de la fonction |
| Règle | La clé de la règle (DSPM-FIN-IBAN-001), sa sévérité et sa catégorie |
| Chemin | La clé de l'objet dans le bucket, base.schéma.table.colonne pour une base, le chemin relatif dans la copie de disque ou le paquet |
| Correspondances | Le nombre de valeurs valides trouvées |
| Échantillon | La dernière valeur trouvée, masquée : deux caractères de chaque côté, le reste remplacé (FR****34) ; une valeur de quatre caractères ou moins devient *** |
| Lignes et échantillon | Pour une base, le nombre de lignes de la table et le nombre de lignes lues |
| Dates et statut | Première et dernière observation, résolution, statut OPEN, RESOLVED ou IGNORED |
Un constat est identifié par le triplet ressource, règle et chemin. À chaque nouveau scan complet de la ressource, les constats qui ne ressortent plus sont fermés. Quand le résultat est incomplet (liste d'objets tronquée, objets non lisibles, colonnes non lues, droits insuffisants), rien n'est fermé : un constat ne disparaît que si Ctadel a pu vérifier son emplacement.
Chaque constat nouveau déclenche une notification de type données vers les canaux configurés, avec la clé de la règle, le chemin et le nombre de correspondances ; voir Notifications. Les constats sont aussi écrits dans le graphe, où les chemins d'attaque les utilisent pour qualifier une ressource exposée qui porte des données sensibles.
La page « Sécurité des données »
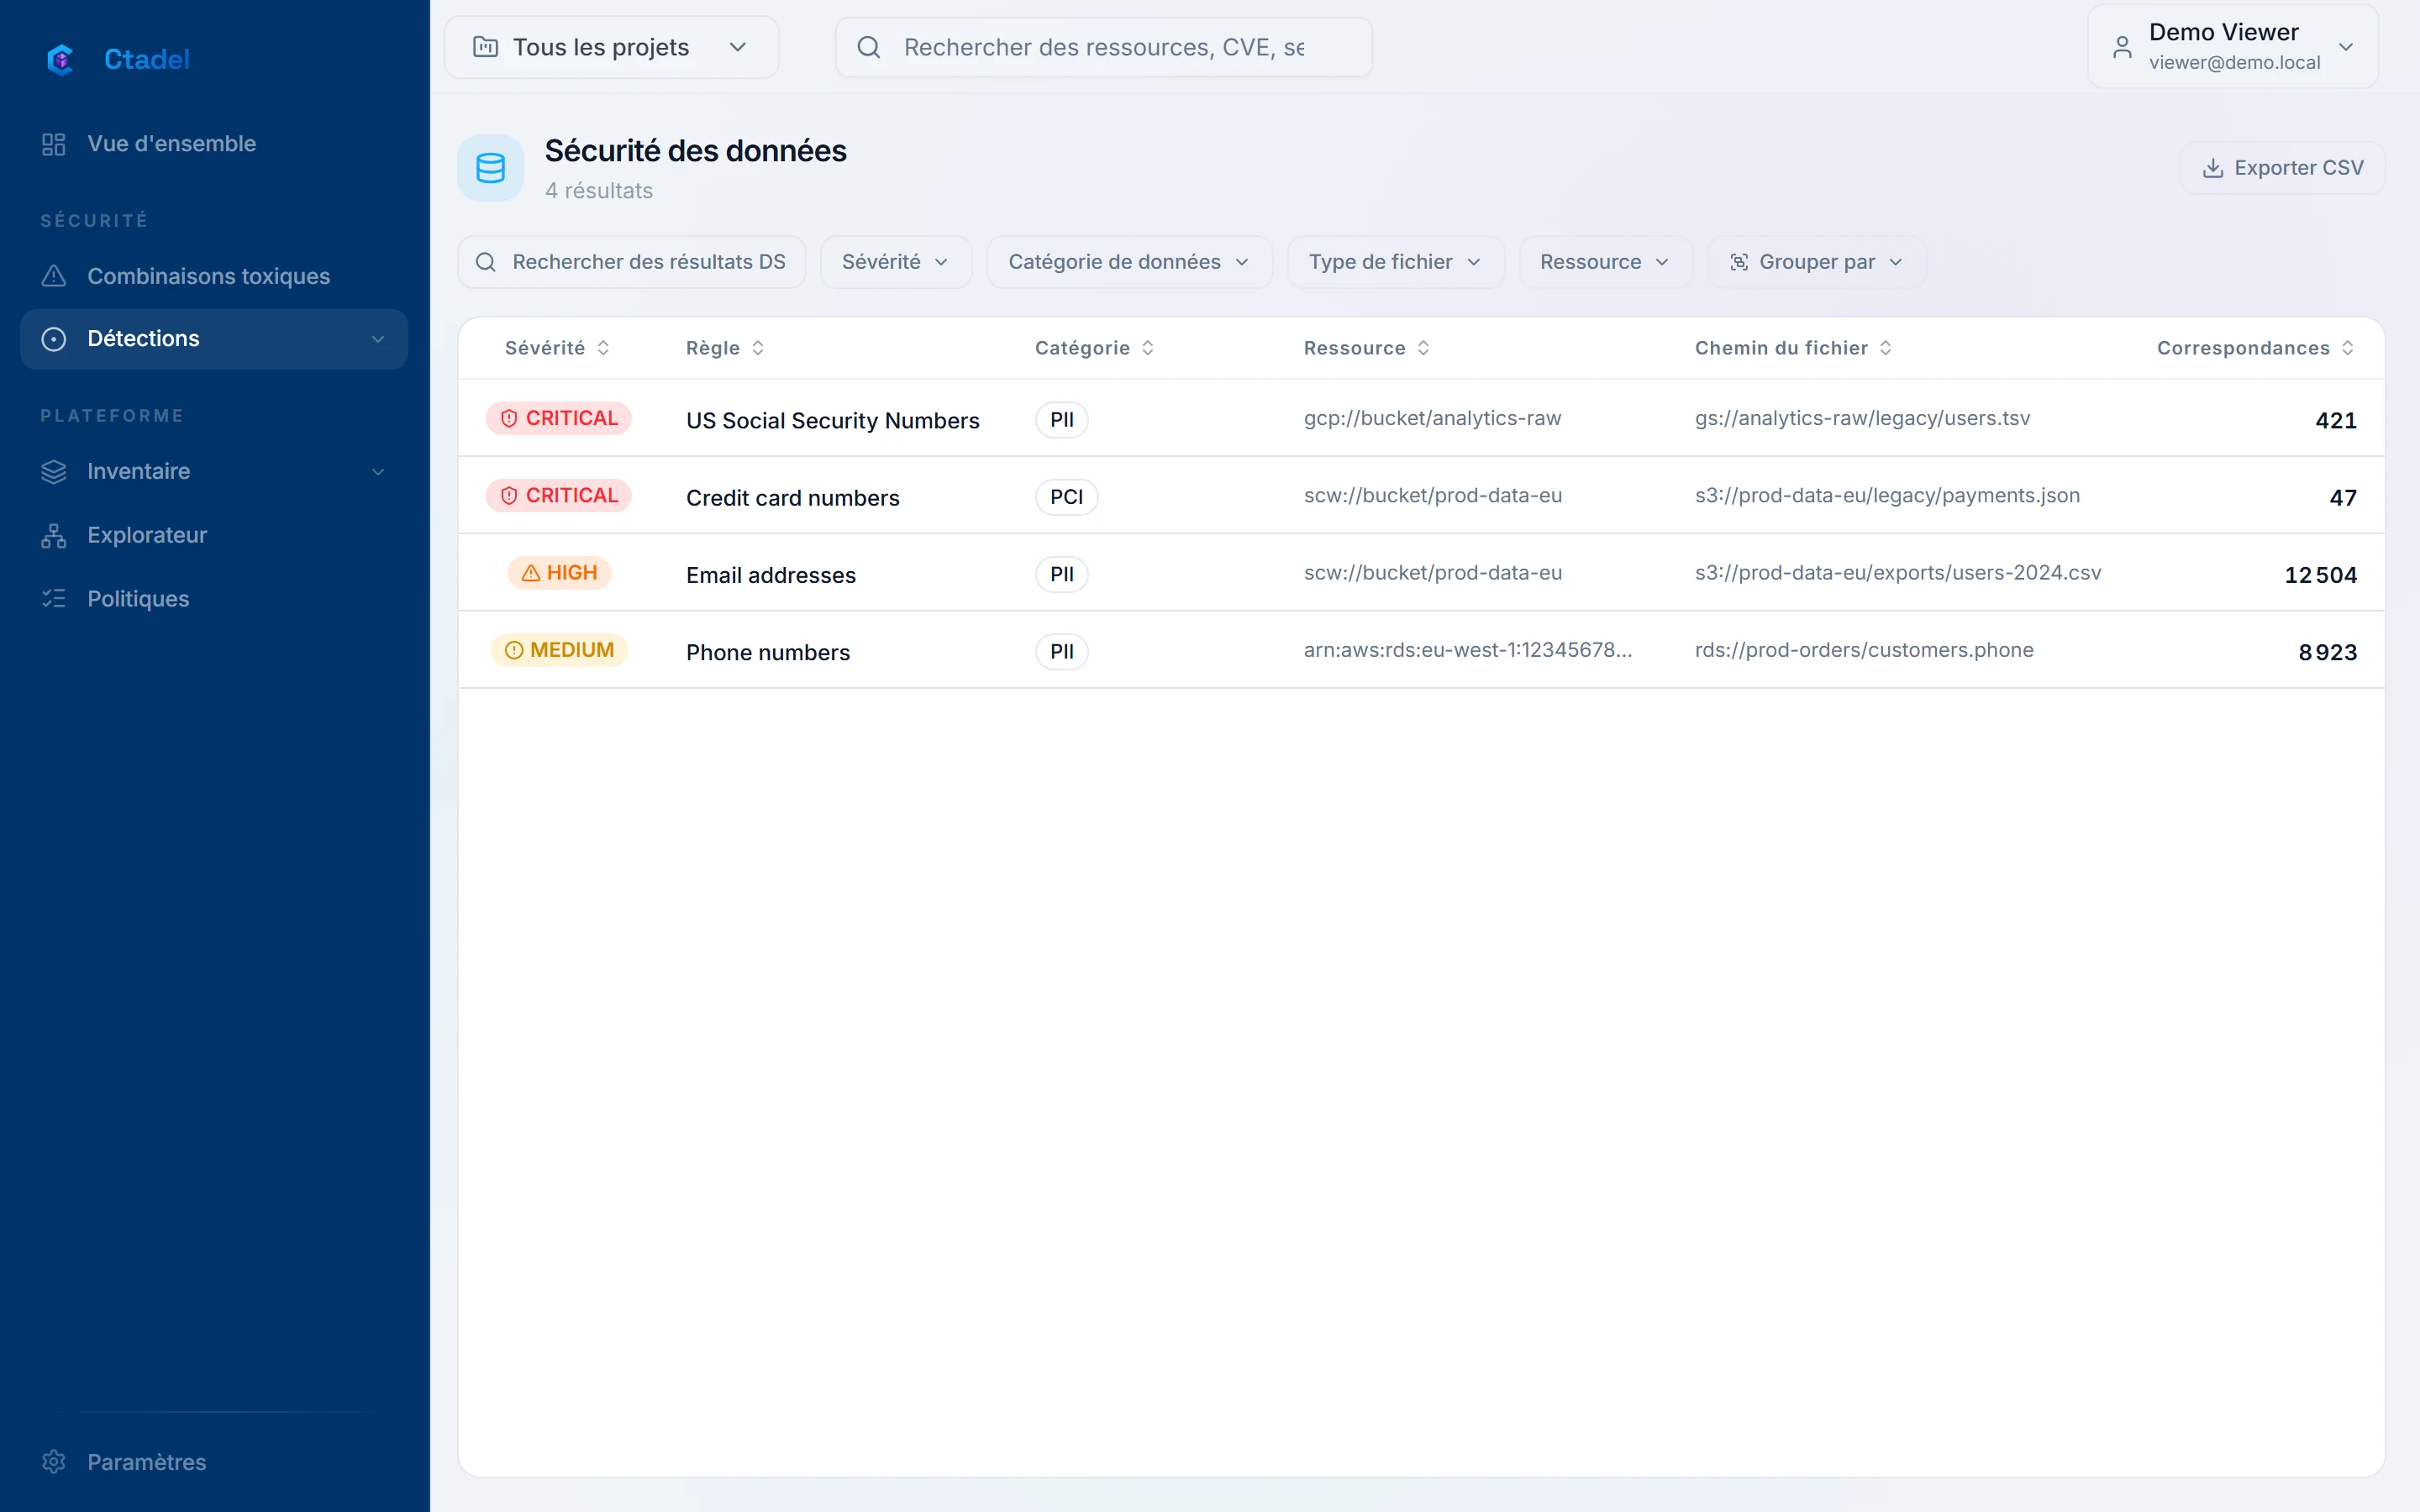
La page « Sécurité des données » (adresse /dspm) liste les constats ouverts du projet actif, triés par sévérité puis par nombre de correspondances, avec les colonnes « Sévérité », « Règle », « Catégorie », « Ressource », « Chemin du fichier » et « Correspondances ». Les filtres portent sur « Sévérité », « Catégorie de données », « Type de fichier » (l'extension du chemin) et « Ressource » ; le regroupement sur « Sévérité », « Catégorie de données » ou « Ressource ». Le bouton « Exporter CSV » exporte la liste filtrée. La page affiche au plus 2 000 constats ; un avis signale quand la liste est tronquée.
Un clic sur une ligne ouvre le panneau de détail. Il affiche la description de la règle, la « Ressource concernée », la section « Échantillon de données » avec l'extrait masqué, le nombre de correspondances et le chemin, et dans la colonne de droite la « Classification des données », la « Catégorie » et les « Correspondances ». Les chemins d'attaque qui passent par la ressource sont listés au-dessus. Le panneau est décrit dans Lire un constat.
Limites
- Le module reconnaît des formats, pas des significations. Une donnée sensible sans format fixe (une adresse postale, un nom, un diagnostic en texte libre, un salaire) n'est pas détectée. Les catégories de l'article 9 du RGPD ne sont pas couvertes.
- Les règles ancrées sur un mot-clé ne trouvent un identifiant nu que si son libellé est à côté : un en-tête de colonne CSV, un nom de colonne SQL, un mot-clé dans le texte. Un fichier de chiffres sans en-tête n'est pas rapporté pour ces règles.
- Dans un bucket, seuls les 10 premiers Mo d'un fichier texte sont lus, et seuls les 100 000 premiers objets sont listés. Les objets extractibles de plus de 50 Mo ne sont pas lus. Un PDF image n'a pas de texte. Les archives au-delà de trois niveaux ou de cent fichiers sont lues en partie.
- Une base n'est lue qu'à partir d'un échantillon de 100 lignes par colonne et de 5 000 colonnes par base ; le nombre total affiché est une estimation. Les colonnes numériques, binaires et de type date ne sont pas lues.
- Seules les instances PostgreSQL d'AWS RDS, Google Cloud SQL et Scaleway sont copiées. Aurora, MySQL, SQL Server, Oracle, MongoDB, Redis, Azure SQL et les bases managées OVHcloud et OUTSCALE ne sont pas scannés.
- La copie de base vit dans votre compte le temps du scan et vous est facturée ; l'instantané RDS et le groupe de sécurité temporaire aussi. Si le compte connecté n'a pas les droits de création et de suppression de ces objets, aucune base n'est scannée.
- Sur une copie de disque, un fichier texte en UTF-16 est pris pour un fichier binaire et n'est pas lu, alors qu'il l'est dans un bucket. Les fichiers de plus de 256 Mo sont comptés comme non lus.
- L'adresse de courriel est détectée sans distinction entre domaine interne et externe.
- La page affiche au plus 2 000 constats ouverts ; l'export CSV porte sur la liste affichée.