
Les chemins d’attaque
Ce qu’est une combinaison toxique, comment une chaîne est évaluée et scorée, pourquoi certaines sont désactivées, comment on la casse, et ce que propose le Sapper.
Cette page explique ce que Ctadel appelle une combinaison toxique, comment une chaîne est évaluée et notée, ce qui ferme un chemin, et ce que le Sapper ajoute.
Ce qu’est une combinaison toxique
Une combinaison toxique est une règle qui porte sur un chemin du graphe et non sur une ressource isolée. Chaque maillon pris seul peut être anodin ou de sévérité moyenne : une instance avec une adresse publique, une version d’IMDS qui livre le rôle sans jeton, un rôle qui lit un bucket, un bucket classé comme contenant des données personnelles. Alignés, ils forment un chemin qu’un attaquant peut suivre de l’Internet jusqu’à une cible.
La page « Combinaisons toxiques » liste ces chemins avec leur « Risque », leur « Sévérité », leur titre et les ressources traversées. Chaque chemin est un constat comme les autres : il a un état, un historique et peut être ignoré ou accepté.
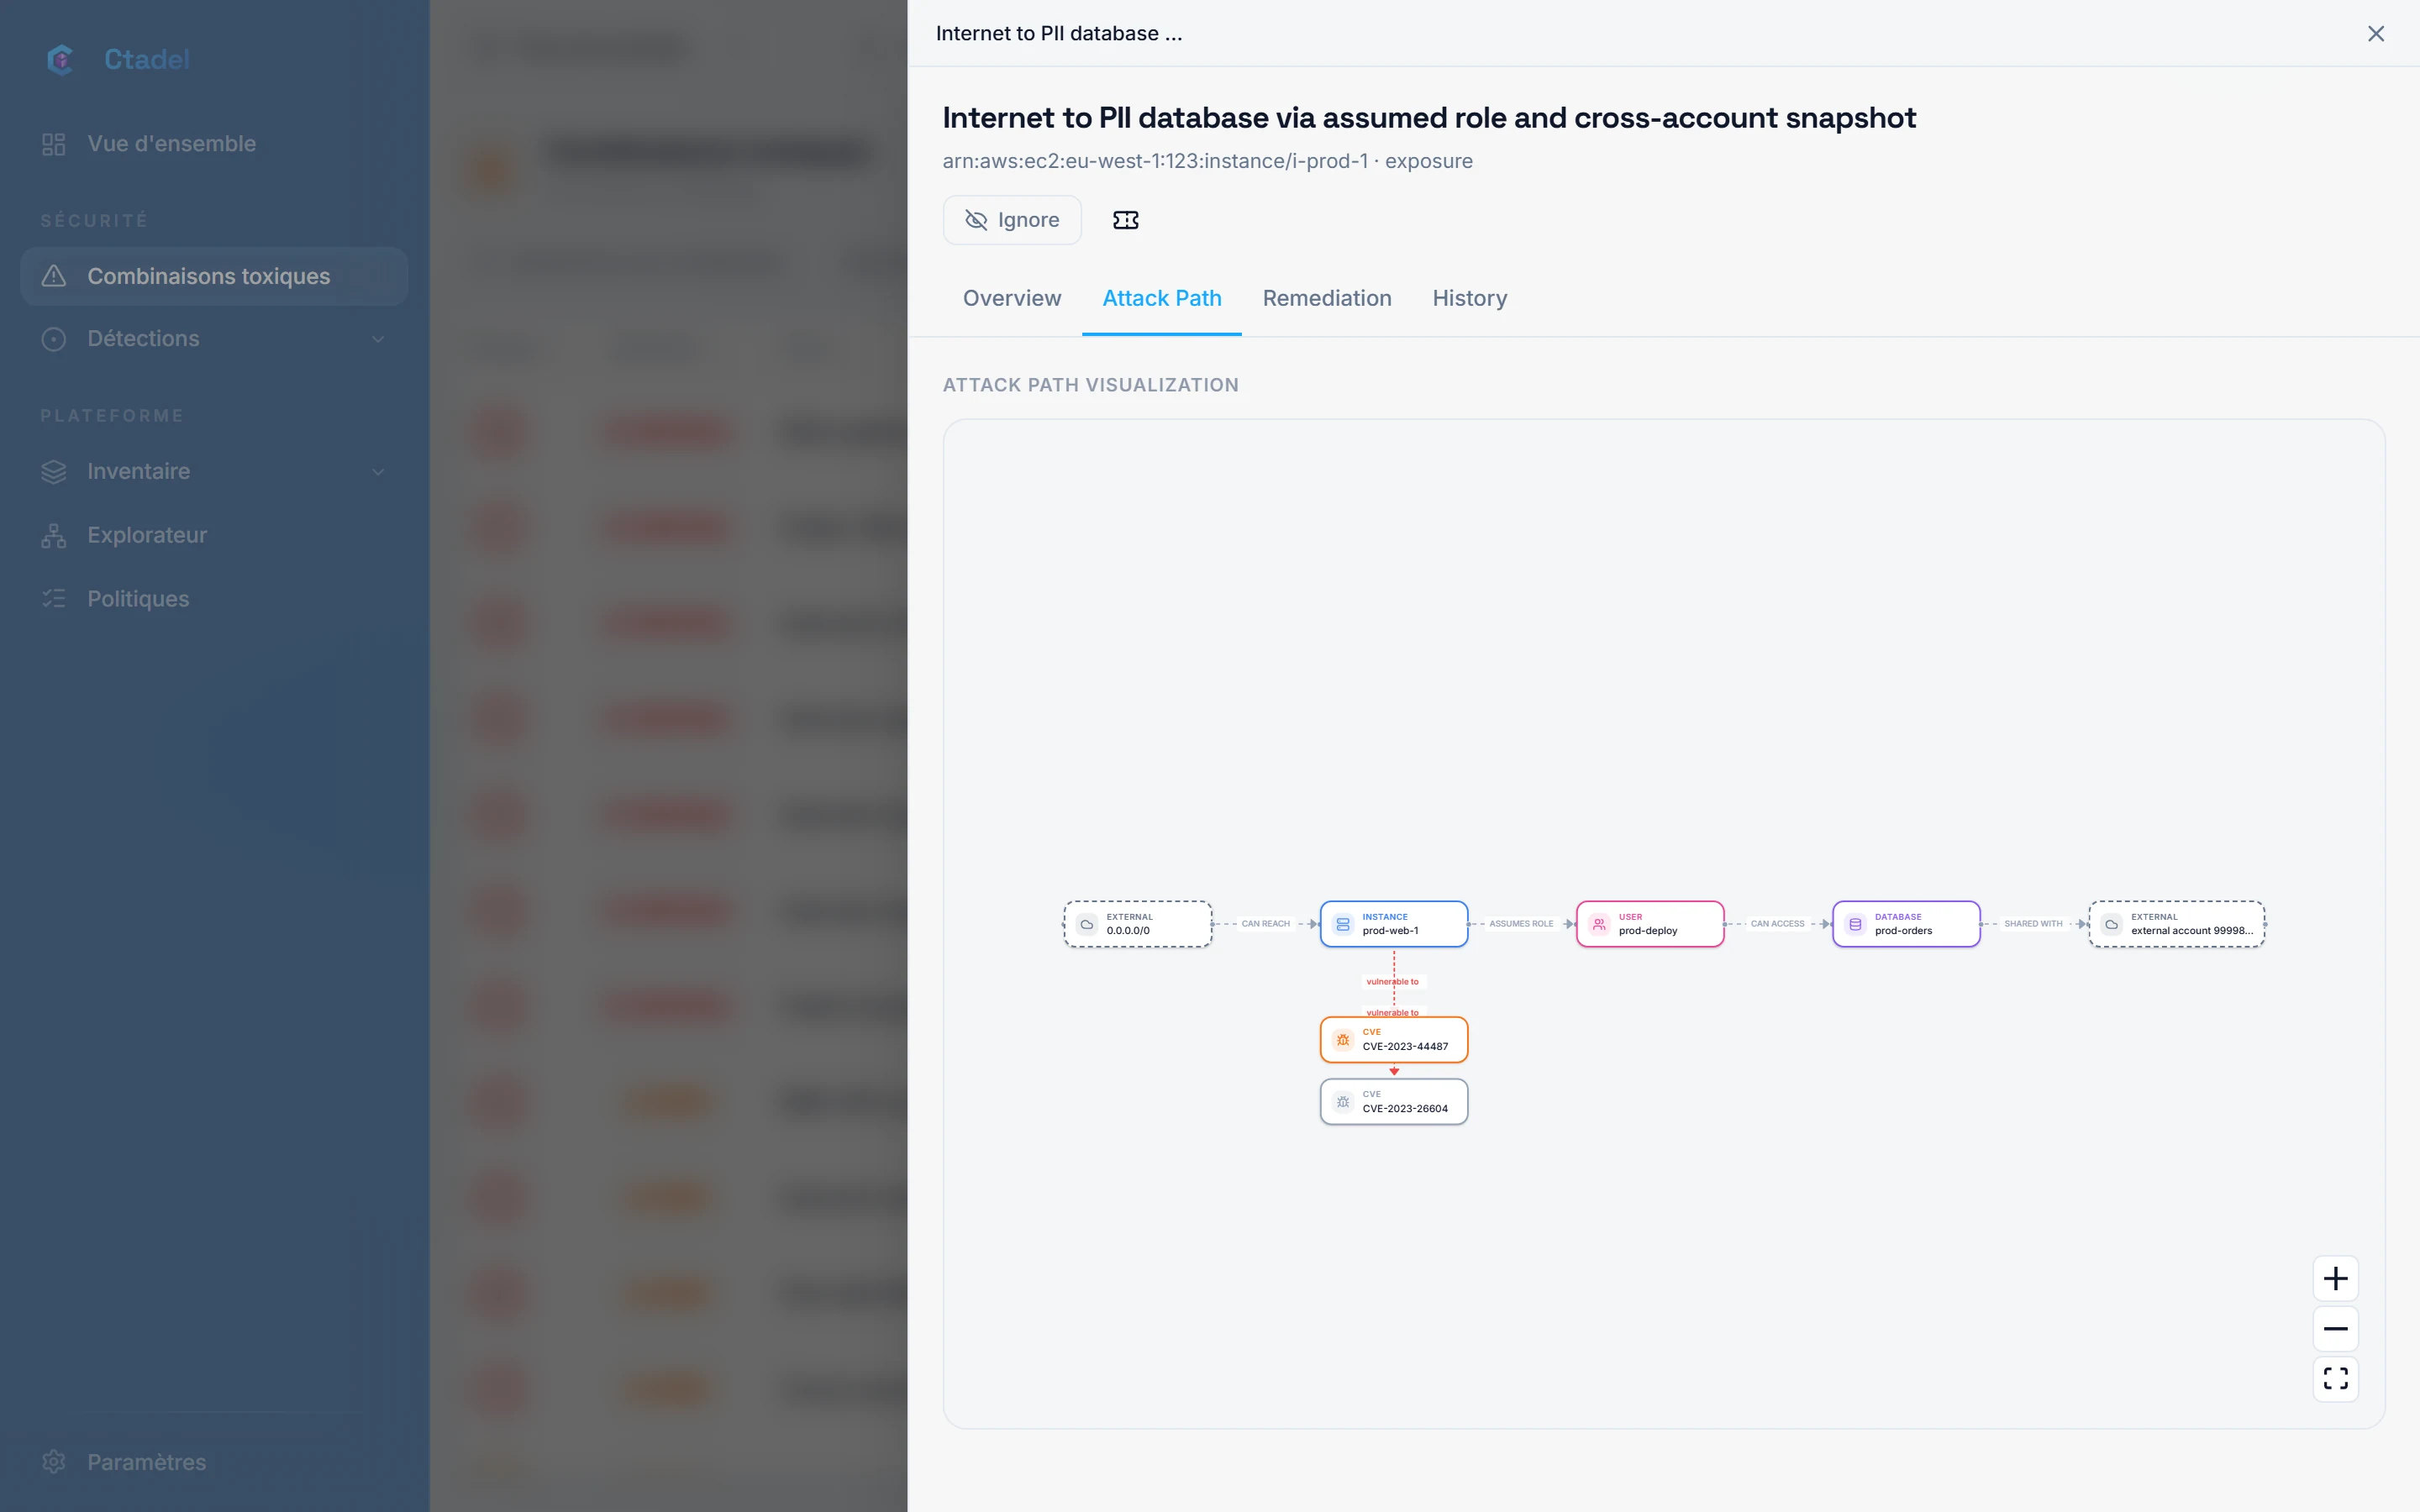
Deux mécanismes produisent ces chemins.
| Mécanisme | Ce qu’il fait | Clés de règle |
|---|---|---|
| Chaînes du catalogue | Une combinaison connue, décrite à l’avance : les types de ressources, les relations et les constats attendus à chaque maillon. | TOX-… |
| Chemins calculés | Ctadel relève dans le graphe les points d’entrée, les faiblesses, les identités et les cibles, puis marche de chaque point d’entrée vers chaque cible sans règle préécrite. | PATH-DATA, PATH-ADMIN, PATH-KEY, PATH-CLUSTER, PATH-STORE |
Comment une chaîne du catalogue est évaluée
Une chaîne du catalogue décrit ses maillons par concepts (« public », « admin », « données sensibles »), chacun couvert par des règles réelles du catalogue. À chaque parcours, Ctadel évalue chaque chaîne activée sur le graphe. Chaque chemin trouvé devient un constat ; le même chemin retrouvé au parcours suivant est le même constat, pas un doublon.
Quelques chaînes du catalogue sont désactivées par défaut ; la raison figure dans leur description. Elles restent visibles dans le catalogue.
Comment un chemin calculé est construit
Ctadel relève d’abord dans le graphe les hôtes et services joignables depuis l’Internet (points d’entrée), les faiblesses qu’ils portent (vulnérabilités, IMDSv1, secrets, évasion de conteneur), les identités qu’ils livrent, les accès de ces identités, et les cibles (données classées sensibles, identités administratrices, clés de chiffrement, clusters Kubernetes, bases non encore classées).
Chaque étape reçoit une probabilité fixe, la même pour tous les clients, publiée ici pour qu’un auditeur puisse la lire.
| Étape | Probabilité |
|---|---|
| Entrée : adresse publique et groupe de sécurité ouvert au monde (ou inconnu) | 0,9 |
| Entrée : adresse publique derrière un groupe de sécurité sans règle ouverte | 0,5 |
| Entrée : derrière un équilibreur de charge public | 0,7 |
| Entrée : service Kubernetes de type LoadBalancer ou NodePort | 0,8 |
| Entrée : point d’accès public d’un cluster | 0,3 |
| Entrée : fonction serverless publique, base publique | 0,8 |
| Entrée : bucket public | 1,0 |
| Exploitation : hôte exposé sans vulnérabilité connue | 0,05 |
| Exploitation : vulnérabilité | probabilité EPSS, portée à 0,9 si la CVE est au catalogue KEV et à 0,95 si elle est utilisée par un rançongiciel |
| Identité livrée par IMDSv1 / IMDSv2 | 0,9 / 0,6 |
| Identité livrée par un compte de service | 0,7 |
| Secret actif / de validité inconnue / inactif | 0,9 / 0,5 / 0,1 |
| Droit d’accès en lecture / en écriture | 0,9 / 1,0 |
| Administration d’un cluster, même identité entre clouds | 1,0 / 0,9 |
| Évasion de conteneur | 0,6 |
La valeur d’une cible va de 0,5 (base de données non classée) à 1,0 (données de santé, de paiement ou personnelles au sens européen), avec 0,8 pour une clé de chiffrement ou un plan de contrôle Kubernetes.
La marche part de chaque point d’entrée, suit au plus 4 relations, garde au plus 5 chemins par point d’entrée et 500 au total, et abandonne une branche dont la probabilité tombe sous 0,005. Elle est bornée en temps et en volume : si une borne est atteinte, les chemins trouvés sont publiés mais marqués incomplets, et aucun chemin calculé existant n’est fermé sur cette base.
Score et sévérité d’un chemin
Pour un chemin calculé, le score est le produit des probabilités de ses étapes, multiplié par la valeur de la cible. Trois faiblesses moyennes qui s’alignent peuvent ainsi dépasser une vulnérabilité critique qui ne mène nulle part. La sévérité en découle : critique à partir de 0,5, haute à partir de 0,2, moyenne à partir de 0,05, basse en dessous. Le « Risque » affiché, de 1 à 100, vaut 20 + 80 × √score : un chemin certain vers des données sensibles vaut 100, un chemin à une chance sur vingt vaut 38.
Pour une chaîne du catalogue, la sévérité est celle de la chaîne. Le risque part d’une base par sévérité (80 critique, 60 haute, 40 moyenne, 20 basse), ajoute 5 par étape jusqu’à 15 et 2 par ressource jusqu’à 10, plafonné à 100. Ctadel le corrige ensuite d’après ce qu’il sait de la première ressource : +15 si elle est joignable depuis l’Internet, +15 si elle porte une faiblesse exploitable, +10 si elle est une cible de valeur, −15 si c’est un hôte ou un dépôt de données que rien ne joint et sans faiblesse. Cette correction n’est pas appliquée quand l’évaluation des chemins calculés est incomplète.
Chaque nœud d’un chemin calculé enregistre pourquoi il s’y trouve : la raison et la probabilité de l’entrée, de l’exploitation, de chaque étape et de l’impact. Le panneau de détail les affiche maillon par maillon.
Comment un chemin se ferme
Un chemin reste ouvert tant que tous ses maillons tiennent. Pour le fermer, il suffit d’en casser un : fermer l’exposition, corriger la vulnérabilité, retirer un droit, chiffrer ou déplacer les données. Le maillon le moins coûteux est souvent une seule correction de configuration ; préférez celui qui a le moins de dépendants, par exemple corriger un hôte plutôt que réécrire un rôle partagé.
Au parcours suivant, l’évaluation ne renvoie plus ce chemin ; il passe à l’état résolu, avec la date et l’auteur « système » dans son historique. Les chemins calculés ne sont fermés ainsi que si leur évaluation était complète : une évaluation incomplète ne ferme rien qu’elle n’a pas pu vérifier. Un chemin dont la règle a été désactivée est fermé de la même façon.
Les propositions du Sapper
Le Sapper est un agent qui cherche dans le graphe des chemins qu’aucune règle ne décrit. Il ne part pas d’une page blanche : avant tout appel au modèle de langue, Ctadel établit l’état des lieux, c’est-à-dire les cibles de valeur, celles qu’un chemin connu atteint déjà, et la frontière, les cibles que rien n’atteint. C’est là seulement qu’il cherche.
Sur la page « Combinaisons toxiques », l’encadré « Sapper » affiche les propositions en attente et le bouton « Chercher maintenant ». Une recherche peut aussi être planifiée à intervalle fixe ; par défaut, elle ne l’est pas. Une recherche est bornée ; si elle s’arrête sur sa borne, la page l’indique : « La recherche s’est arrêtée sur son budget : il peut rester des chemins à trouver. »
Une proposition contient un titre, une sévérité, une confiance, le « Chemin vérifié » maillon par maillon, les « Preuves » lues dans le graphe et une « Règle généralisée (Cypher) » qui décrit le motif sans citer les identifiants des ressources. Ctadel refuse une règle qui nomme un label, une relation ou une propriété que le graphe n’a pas. Vous décidez : « Accepter comme règle » crée une règle toxique personnalisée de votre instance, évaluée avec le catalogue dès le parcours suivant et immédiatement sur la première ressource du chemin ; « Rejeter » archive la proposition avec votre motif. Le Sapper lit tout le graphe : il n’est disponible qu’aux utilisateurs qui ont accès à tous les projets.
Limites
- Les probabilités et les valeurs de cible sont des jugements fixés par Ctadel, identiques pour tous ; elles ne sont pas mesurées sur votre environnement.
- La joignabilité n’est calculée que pour les hôtes, les services et les dépôts de données ; une identité, une clé ou un cluster n’est jamais un point d’entrée.
- Un chemin calculé traverse au plus 4 relations ; 5 chemins par point d’entrée et 500 au total sont conservés. Au-delà d’une borne de temps ou de volume, le résultat est marqué partiel.
- La probabilité d’exploitation d’une vulnérabilité vient d’EPSS et du catalogue KEV ; quand ces données ne sont pas encore synchronisées, une valeur de repli par sévérité est utilisée (0,2 critique, 0,1 haute, 0,03 moyenne, 0,01 sinon).
- Une base de données managée n’est pas analysée pour les vulnérabilités, une image machine ne l’est pas pour les secrets, et l’identité de charge de travail Kubernetes n’est pas modélisée : les chaînes qui en dépendent sont désactivées.
- Quand l’évaluation des chemins calculés échoue ou est incomplète, le risque des chaînes du catalogue n’est pas corrigé et aucun chemin calculé n’est produit ni fermé pour ce parcours.
- Les filtres de catégorie de la page (« Exposition », « Mouvement latéral », « Élévation de privilèges », « Accès aux données ») ne correspondent pas aux catégories que portent les chaînes du catalogue.
- Le Sapper propose ; il ne crée rien sans votre acceptation, et ses recherches planifiées sont désactivées par défaut.